


コラム
サーバー障害の対策とは?外的要因と内的要因から安定運用のポイントを解説
サーバー障害は、企業のWebサイトや業務システムを停止させ、販売機会の損失や社会的信用の低下を招く深刻なリスクです。障害の原因はアクセス集中やサイバー攻撃といった外的要因から、機器の故障やヒューマンエラーといった内的要因まで多岐にわたります。
本記事では、サーバー障害の定義と企業が直面するリスク、障害を引き起こす主な原因、未然防止と迅速な復旧のための対策方法、そしてクラウドとデータセンターを組み合わせた安定運用のポイントについて解説します。
目次
サーバー障害とは?発生時に企業が直面する事態
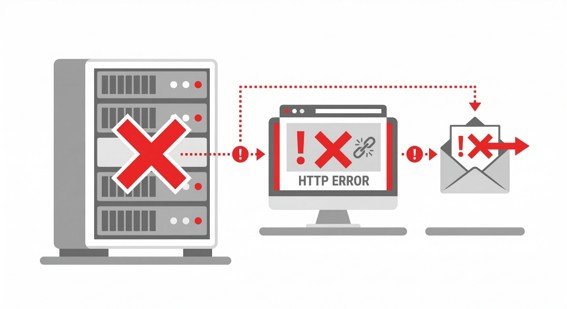
サーバー障害は、企業の事業活動に深刻な影響を及ぼすトラブルです。障害の具体的な症状と、企業経営に直結するリスクを整理します。
サーバー障害の定義と具体的な症状
サーバー障害とは、サーバーの機器やソフトウェアに異常が発生し、本来の機能が停止または低下するトラブルの総称です。障害が発生すると、そのサーバーに紐づくサービスやシステムは正常に利用できなくなります。
具体的な症状として、Webサイトが表示されなくなる、業務システムにアクセスできなくなる、メールの送受信ができなくなるといった事象が挙げられます。そのほか、動作の著しい遅延、頻繁な再起動やフリーズ、エラーメッセージの表示も障害の初期兆候です。
復旧までの時間は原因によって異なり、アクセス集中であれば1時間程度、サイバー攻撃が原因の場合は数日から数週間を要することもあります。初期症状の段階で異常を検知し、迅速に対応する体制を整えておくことが重要です。
企業経営に直結する3つの重大リスク
サーバー障害が発生した場合、企業は主に3つのリスクに直面します。
|
リスク |
内容 |
| 販売機会の損失 | ECサイトやWebサービスの停止は売上の減少に直結する。決済システムや予約システムが利用不能になれば顧客はそのまま離脱し、復旧後も戻らないリスクがある。 |
| 社会的信用の失墜 | 停止時間が長引くほど顧客や取引先からの信頼は低下する。対応が不適切であればクレームや風評被害に発展するケースもある。 |
| 社内業務の停滞 | 基幹業務システムやメールサーバーが停止すれば、従業員の業務が遅延もしくは完全に止まる。 |
このように、サーバー障害はわずかな時間の停止であっても、売上・信用・生産性の3つの側面から企業活動全体に波及する重大なリスクを伴います。
サーバー障害を引き起こす主な原因
サーバー障害の原因は、大きく外的要因と内的要因に分けられます。それぞれの代表的な原因を把握しておくことが、適切な対策を講じる第一歩です。
外的要因
サーバー障害における外的要因とは、サーバーの外部から発生する事象によって障害が引き起こされるケースです。
|
外的要因 |
内容 |
| アクセス集中による過負荷 | テレビやSNSでの話題化、大規模キャンペーン時などにサーバーの処理能力を超えるリクエストが集中し、動作が停止する。 |
| サイバー攻撃 (DDoS攻撃 ・ウイルス感染等) |
DDoS攻撃は複数の端末から大量データを送りつけサービスを停止に追い込む手法。ランサムウェアにより金銭を要求されるケースも増加している。 |
| 自然災害 (地震・台風・落雷等) |
電力設備やコンピュータ施設が損壊し、サーバーの物理的な稼働環境が失われる。日本は発生頻度が高く、災害対策は不可欠。 |
これらの外的要因は、いずれも自社の努力だけでは発生そのものを防ぐことが困難なため、障害が起きた場合にも事業を継続できる備えが求められます。
内的要因
サーバー障害における内的要因とは、サーバーの内部や社内に原因がある障害です。
|
内的要因 |
内容 |
| ハードウェアの故障 | 24時間稼働するサーバーは部品が熱を帯びやすく経年劣化が進む。耐用年数を超えた機器は予告なく故障するリスクが高まる。 |
| ソフトウェアの不具合 (バグ) |
OSやアプリケーションのバグ、メンテナンス時のアップデートや設定変更をきっかけに障害が発生するケースがある。 |
| ヒューマンエラー | 重要ファイルの誤削除、バックアップの消去、ネットワーク設定の誤りなど、人為的ミスによる障害は発生頻度が高い。管理人材が不足する環境ではリスクが増大する。 |
内的要因は日常の運用管理や体制整備によって発生リスクを低減できるため、機器の定期点検や作業手順の標準化など、平常時からの対策が重要です。
サーバー障害を未然に防ぎ、迅速に復旧するための対策方法
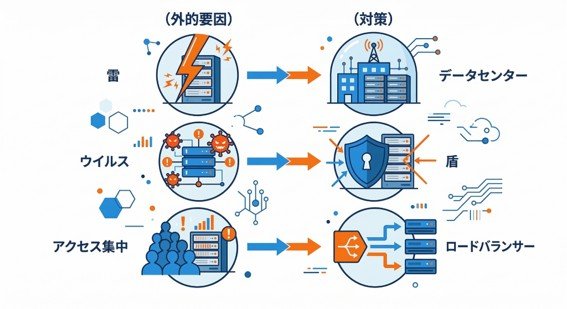
サーバー障害の原因は多岐にわたるため、対策も原因に応じた多層的なアプローチが求められます。外的要因と内的要因のそれぞれに対応する具体的な対策方法を解説します。
外的要因への対策
サーバー障害における外的要因への対策を原因別に整理します。
アクセス集中に対しては、ロードバランサー(負荷分散装置)の導入が有効です。複数サーバーに処理を分散させ、サーバー冗長化とあわせることで障害時の自動切り替えも実現できます。
サイバー攻撃に対しては、WAFやIDS/IPSなどのセキュリティ製品の導入が不可欠です。ソフトウェアの脆弱性対策やログ監視の徹底もあわせて実施し、攻撃リスクを低減します。
自然災害に対しては、サーバーの設置場所の見直しが重要です。耐震性能や電源冗長化を備えたデータセンターの活用や、クラウドで地理的に離れたリージョンへバックアップを配置する対策が有効です。
内的要因への対策
サーバー障害における内的要因への対策を原因別に整理します。
機器の故障やシステムトラブルに対しては、冗長化が基本的な対策です。予備サーバーを準備し、障害発生時に自動で切り替わる構成にしておくことで、サービスの停止時間を最小化できます。あわせて死活監視やリソース監視を導入し、CPU使用率やメモリ使用量、ディスク容量などの異常を早期に検知できる体制を整えることが重要です。異常の兆候を捉えた段階で対処できれば、障害の発生そのものを未然に防ぐことが可能です。
関連記事:サーバー冗長化とは?障害時や災害時の事業継続を実現
ヒューマンエラーに対しては、作業手順のマニュアル化とダブルチェック体制の整備が基本です。設定変更やメンテナンスは手順書に基づき複数名で確認することで、ミスの発生率を低減できます。さらに定型作業はスクリプト化やツールによる自動化を進め、人手による操作を極力減らすことが推奨されます。
その他の対策
外的要因、内的要因のどちらにも有効な対策として、定期的なバックアップの取得が挙げられます。バックアップ構成の基本である3-2-1ルールに従い、複数のバックアップデータを異なる筐体・場所に保存しましょう。また、サイバー攻撃に多いランサムウェアへの対策として、データを書き換え不可(イミュータブル)領域に保存することで、より安全性を高めることができます。
関連記事:災害・ランサムウェア対策に効果的な3-2-1ルールとは?導入のポイントと注意点を解説
また、BCMやBCPの観点から対策を講じることも重要です。非常時の対応を予め決めておくことで、障害発生時に迅速に行動が可能となります。対応マニュアルや連絡網の整備や、定期的な訓練を実施しておきましょう。
関連記事:BCM(事業継続マネジメント)とは?BCPとの違いや策定方法をわかりやすく徹底解説
可用性を最大化する「ハイブリッド」という選択肢
サーバー障害の対策として、クラウドの利用を検討する企業は少なくありません。クラウドは自社でのハードウェア調達が不要なため故障の心配が無く、かつリソース変更が容易なためアクセス高負荷による障害のリスクも抑えられます。
しかし、すべてをクラウドに任せることが最適とは限りません。従量課金制によるコストの高騰や、機密データ管理に関するセキュリティ上の懸念もあります。
これらの理由により、近年では物理サーバーとクラウドを組み合わせる「ハイブリッド」構成が台頭してきました。機密性の高いデータや基幹システムは、安定性のあるデータセンターの物理環境に管理し、アクセス変動が大きいWebシステムは、柔軟性に優れるクラウドに配置するといったように、システム要件ごとに使い分けることで、可用性とコストの最適バランスを実現できます。
関連記事:ハイブリッドクラウドとは?メリットや注意点、オンプレミス回帰が選ばれる理由を解説
まとめ
本記事では、サーバー障害の定義と企業が直面するリスク、外的・内的要因、原因に応じた対策方法、そしてハイブリッド構成の有効性について解説しました。
サーバー障害はさまざまな原因で発生し、販売機会の損失や社会的信用の低下、社内業務の停滞といった経営リスクに直結します。原因に応じた多層的な対策に加え、3-2-1ルールに基づいたバックアップの取得や、BCM・BCPにおける非常時のマニュアル整備や訓練などの実施が大切です。
サーバーの設置環境は障害対策の根幹です。AGSの都市型データセンター「さいたまiDC」は、データセンターファシリティスタンダードの最高レベルに当たるティア4に準拠した設計で、震度7レベル対応の免震構造、二重化された受電設備や冗長構成のUPS、即時起動型非常用発電システムを備えています。
セキュリティ面では7箇所のセキュリティゲートとICカード・静脈認証による2要素認証、24時間365日の有人監視体制を整備し、FISC安全対策基準に準拠しており安全性の高い仕様となっております。
ハウジングサービスご利用のお客様にはオーダーメイドのマネージドサービス(MSP)も提供しています。サーバーの安定運用やBCP対策の強化をご検討の際は、ぜひご相談ください。